
Pregunta 1
Shawn Wang
x.com/swyxLatent Space writer and podcast host who covers AI engineering, from building agents on foundation models to testing and verifying what they do.
¿Cómo cambiará la IA el mundo?
Horizontal: su perspectiva Doom–Bloom expresada. Vertical: escala de la transformación.
Doom–Bloom: 74 de 100. Escala de la transformación: 53 de 100. Rangos de interpretación: de 69 a 79 en horizontal y de 40 a 60 en vertical. Son coordenadas de interpretación, no probabilidades de eventos.
≈7%
Inferido a partir de sus respuestas simuladas, no de un número que haya dado. Rango plausible: 4–14%.
Un supuesto central
Overall, I expect AI to be strongly beneficial if we successfully turn capability into reliable, accessible systems.Respuesta 2
Si este supuesto resultara distinto, ¿cómo cambiaría su perspectiva?
Qué podría hacer cambiar de opinión
The biggest update would come from real-world evidence that AI can reliably accelerate hard science—not just produce plausible hypotheses, but contribute to validated advances in medicine, materials, or climate.Respuesta 3
¿Qué evidencia bastaría y en qué dirección movería su visión?
Más detalles
Se esperan beneficios sustanciales, con condiciones importantes o límites en su distribución.
68 / 100
Rango de interpretación de 67 a 67 en la escala cualitativa.
Varias lecturas siguen siendo plausibles: Se espera que los daños graves o generalizados sean una parte significativa del futuro. / Se esperan daños manejables o localizados.
52 / 100
Rango de interpretación de 33 a 67 en la escala cualitativa.
Las decisiones humanas pueden redirigir sustancialmente la trayectoria de la IA.
63 / 100
Rango de interpretación de 46 a 79 en la escala cualitativa.
Detener o frenar considerablemente el desarrollo de IA más capaz.
Posición simulada: Continuar el desarrollo con las salvaguardas indicadas.
Acelerar el desarrollo de IA más capaz.
Restringir los usos de la IA mencionados hasta que existan protecciones o permisos previos.
Posición simulada: Permitir los usos de la IA mencionados con rendición de cuentas y protecciones específicas.
Reducir al mínimo las restricciones a los usos de la IA mencionados.
Estas interpretaciones conservan las condiciones que se indicaron. Los beneficios y los daños pueden ser considerables a la vez. Los rangos describen cómo leemos sus respuestas simuladas, no intervalos de confianza estadísticos.
Visiones similares
Líderes de opinión cuyas visiones simuladas son las más cercanas a la de Shawn Wang
Evaluación simulada
Fuentes
Artículos, entrevistas y textos usados para fundamentar a este usuario simulado.
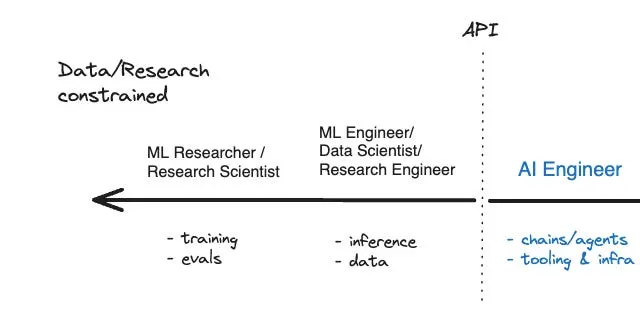
Describes AI engineering as productizing foundation models with software, data and evaluations.

First-party current index linking agent engineering work and the 2025 agent-lab essay; establishes scope, not a catastrophe forecast.

Argues agent labs translate model capabilities into useful products through extensive integration and engineering; acknowledges many harnesses are superseded and uncertainty about competition from model labs.

Acknowledges AI-linked wealth concentration but rejects fatalistic permanent-underclass narratives, arguing AI lowers barriers to learning, entrepreneurship and upward mobility for people who exercise agency.

His keynote essay treats intent, tools, control flow, planning, memory and delegated authority as essential agent ingredients. Argues improved models, tools and economics create a major engineering opportunity; emphasizes trust and verification rather than equating autonomy with reliability.

Speaker-attributed transcript: at 32:53 he expects coding agents to expand beyond coding; at 40:01–41:18 he raises biosafety concerns and doubts broad enterprise distribution is truly private access. At 44:30–48:58 he identifies memory constraints, revises upward on open models, and favors automated testing and verification as human code review becomes a bottleneck. No numeric p(doom) given.

His own questions at 45:42–47:58 distinguish inaccessible reasoning traces, observable actions and simulations without real consequences for lying. This supports attention to evaluation validity; the guests’ model-behavior findings and risk judgments remain theirs, not his.

At 33:41–36:24 he identifies GPU access as a constraint on autonomous research, questions how widely research loops are used beyond demonstrations, and favors agents provisioning their own infrastructure. Modal deployment and performance claims belong to guest Akshat Bubna.

Argues applying AI engineering to hard science could be among this century’s most important missions, spanning medicine, materials, climate and AI research. Explicitly avoids assigning AGI or superintelligence timelines; calls for engineering talent to pursue science rather than low-value output.

¿Dónde te ubicas?
Mapear mi visión de la IA