Doom or Bloom


Pergunta 1
O que você acha que a IA significa para o nosso futuro — e por quê?
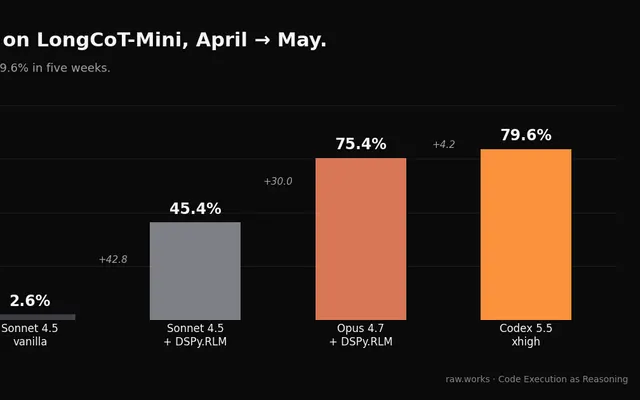
I think AI’s future is less about a single universally intelligent model and more about systems: models, tools, executable code, memory, verification, permissions, and feedback loops working together. A model that looks limited in a chat interface may perform substantially better when its harness lets it inspect state, run code, test hypotheses, and recursively revise its work. That means many apparent “model capabilities” are really properties of the whole system.
Practically, I expect increasingly capable agents for both coding and noncoding workflows. General LLMs can handle open-ended interpretation, while smaller specialized decision models operate over compressed state and structured action spaces. That division may be more useful, controllable, and efficient than forcing one general model to do everything.
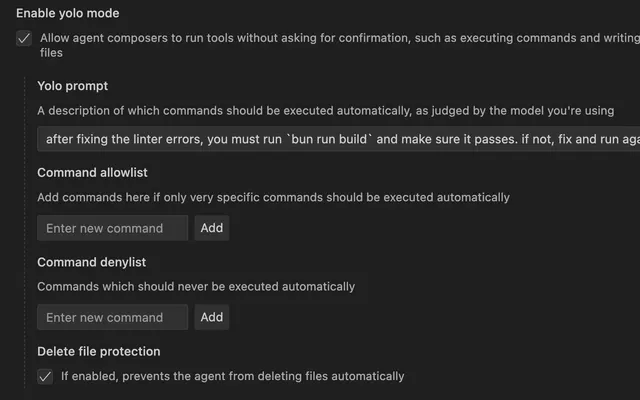
But capability without reliability is not enough. The system needs measurable outcomes, tests, verification, and constrained permissions. A conversational model can sound cautious while its agent harness aggressively edits files, invokes tools, or exposes private data. Safety therefore has to be evaluated at the level where actions occur, not inferred from tone.
Privacy and control will also shape which applications are viable. Sensitive personal and process-level uses often require local execution, self-hosting, or credible zero-data-retention options. So I’m optimistic about what these systems can do, but the important question is not merely how intelligent the model appears. It is whether the complete system produces useful, verifiable results without taking unacceptable liberties with data or actions.