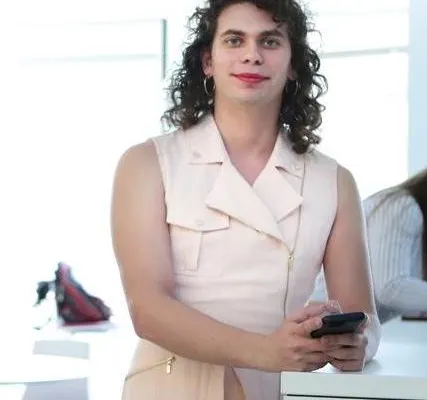
Stella Biderman

Stella Biderman

x.com/blancheminerva

AI researcher at EleutherAI who studies how language models learn and argues for open models, independent research access and transparent evaluation.

Bagaimana AI akan mengubah dunia?

Perubahan peradabanPerubahan bertahapDoomBloom
Posisi simulasiRentang interpretasi

Mendatar: pandangan Doom–Bloom yang mereka ungkapkan. Ke atas: skala transformasi.

Doom–Bloom: 50 dari 100. Skala transformasi: 43 dari 100. Rentang interpretasi: 45 hingga 55 secara horizontal, 0 hingga 100 secara vertikal. Ini adalah koordinat interpretasi, bukan probabilitas kejadian.

P(doom) Stella Biderman · disimpulkan

≈8%

0%100%

Disimpulkan dari jawaban simulasi mereka, bukan angka yang mereka berikan. Rentang yang masuk akal: 4–17%.

Hal-hal yang menentukan pandangan mereka

Asumsi utama

Its impact is conditional on institutions: who controls access, whether independent researchers can inspect models and training dynamics, whether evaluations are transparent, and whether organizations are accountable for ordinary security and deployment failures.
Jawaban 2

Jika asumsi ini ternyata berbeda, bagaimana pandangan mereka akan berubah?

Pertanyaan yang belum terjawab

I do not have a defensible single forecast that AI will be beneficial or harmful overall.
Jawaban 2

Apa yang akan membantu mereka membedakan hasil-hasil yang masuk akal di sini?

Hal yang dapat mengubah pandangan mereka

The most consequential evidence would be a robust empirical finding that independent access itself creates severe, unavoidable harms that cannot be mitigated without concentrating control.
Jawaban 3

Bukti apa yang akan memadai, dan ke arah mana bukti itu akan mengubah pandangan mereka?

Detail lebih lanjut

Manfaat yang diperkirakan

Manfaat yang terbatas atau hanya tersebar secara sempit diperkirakan akan terwujud.

46 / 100

Dampak kecilDampak transformatif

Rentang interpretasi 33 hingga 67 pada skala kualitatif.

Kerugian yang diperkirakan

Kerugian yang dapat dikelola atau bersifat lokal diperkirakan akan terjadi.

35 / 100

Dampak kecilDampak transformatif

Rentang interpretasi 33 hingga 33 pada skala kualitatif.

Pengaruh manusia

Pilihan manusia dapat mengarahkan ulang lintasan AI secara signifikan.

72 / 100

Sedikit pengaruhPengaruh kuat

Rentang interpretasi 50 hingga 75 pada skala kualitatif.

Laju pengembangan

Hentikan atau perlambat secara signifikan pengembangan AI yang lebih mampu.

Posisi simulasi: Lanjutkan pengembangan dengan perlindungan yang telah ditetapkan.

Percepat pengembangan AI yang lebih mampu.

Akses ke AI

Batasi akses ke AI yang berkemampuan tinggi.

Izinkan akses dengan tunduk pada pembatasan kemampuan atau penggunaan.

Posisi simulasi: Utamakan akses yang luas atau terbuka ke AI yang berkemampuan tinggi.

Interpretasi ini mempertahankan kondisi yang mereka nyatakan. Manfaat dan kerugian dapat sama-sama besar. Rentang tersebut menggambarkan cara kami membaca jawaban simulasi mereka, bukan interval kepercayaan statistik.

Di mana posisi Anda dibandingkan dengan Stella Biderman?
Petakan pandangan dunia AI Anda sendiri dalam waktu sekitar 3 menit, lalu bandingkan

Pandangan dunia serupa

Pemimpin opini dengan pandangan dunia simulasi yang paling mendekati pandangan Stella Biderman

Penilaian Simulasi

Pertanyaan 1

Menurut Anda, apa arti AI bagi masa depan kita—dan mengapa?

I think AI’s impact will depend less on treating models as autonomous forces and more on the institutions that build, study, deploy, and govern them. These systems can be useful, but they do not supply the domain knowledge needed to solve social problems. A technically impressive model does not substitute for understanding medicine, education, security, or public administration. The central question is who can examine and shape these systems. If meaningful research is restricted to a few large companies, outsiders cannot adequately investigate training dynamics, memorization, bias, security failures, or safety claims. Open models, checkpoints, public compute, transparent evaluations, and clear policy criteria make empirical scrutiny possible. Closed APIs and superficial filters can instead hide problems without resolving them. So I do not think our future is determined by an analogy to nuclear weapons or by concentrating control in a small number of incumbents. Those framings can mislead policymakers while doing little to prevent powerful models from being developed. A better future requires open competition, independent research, outside participation in policy, institutional accountability, and a science of how training actually produces capabilities and behavior.

Pertanyaan 2

Taking benefits and harms together, what overall impact do you expect AI to have?

I do not have a defensible single forecast that AI will be beneficial or harmful overall. Its impact is conditional on institutions: who controls access, whether independent researchers can inspect models and training dynamics, whether evaluations are transparent, and whether organizations are accountable for ordinary security and deployment failures. AI can support useful work, but it cannot replace domain expertise or repair weak institutions by itself. Harms are more likely to be obscured when scrutiny is limited to a few companies, while open models, public compute, checkpoints, and outside participation make problems easier to discover and contest. So I expect neither an automatic technological utopia nor an autonomous catastrophe. The balance will be shaped substantially by governance, research access, and deployment choices.

Pertanyaan 3

Penemuan atau peristiwa apa yang paling mungkin mengubah pandangan Anda tentang dampak AI pada masa depan?

The most consequential evidence would be a robust empirical finding that independent access itself creates severe, unavoidable harms that cannot be mitigated without concentrating control. That would challenge my view that open models, checkpoints, public compute, and outside scrutiny generally improve accountability. Conversely, clear evidence that openness consistently exposes failures earlier, improves interventions, and supports useful competition would strengthen that view. I would also update substantially if research on training dynamics produced reliable ways to predict capabilities and safety-relevant behavior before deployment—or demonstrated that such prediction is fundamentally ineffective. The key would not be a dramatic analogy or isolated incident, but reproducible evidence about how models develop, how failures occur, and which institutions actually manage those failures well.

Sumber

Artikel, wawancara, dan tulisan yang digunakan sebagai landasan bagi pengguna simulasi ini.

Di mana posisi Anda?
Jelajahi pandangan dunia AI Anda sendiri dengan menjawab beberapa pertanyaan sederhana.
Petakan pandangan dunia Anda sendiri

Di mana posisi Anda?

Petakan pandangan dunia saya