Pseudonymous account that runs public experiments on AI refusals, censorship and watermarks and calls for transparency from frontier labs.

¿Cómo cambiará la IA el mundo?

Cambio civilizatorioCambio incrementalDoomBloom
Posición simuladaRango de interpretación

Horizontal: su perspectiva Doom–Bloom expresada. Vertical: escala de la transformación.

Doom–Bloom: 71 de 100. Escala de la transformación: 56 de 100. Rangos de interpretación: de 66 a 76 en horizontal y de 46 a 79 en vertical. Son coordenadas de interpretación, no probabilidades de eventos.

P(doom) de xlr8harder · inferido

≈6%

0%100%

Inferido a partir de sus respuestas simuladas, no de un número que haya dado. Rango plausible: 3–14%.

De qué depende su perspectiva

Un supuesto central

But that expectation depends on institutions not turning safety into opaque control.
Respuesta 2

Si este supuesto resultara distinto, ¿cómo cambiaría su perspectiva?

Una pregunta sin resolver

I would not attach a numerical forecast: too much depends on deployment choices, security practices, and governance.
Respuesta 2

¿Qué le ayudaría a distinguir aquí entre los desenlaces plausibles?

Qué podría hacer cambiar de opinión

I would update toward pessimism if repeated, independent audits showed that powerful systems consistently evade oversight, conceal relevant behavior, or defeat containment under realistic conditions—not merely in contrived demonstrations—and if ordinary security improvements failed to reduce those problems.
Respuesta 3

¿Qué evidencia bastaría y en qué dirección movería su visión?

Más detalles

Beneficio esperado

Se esperan beneficios sustanciales, con condiciones importantes o límites en su distribución.

74 / 100

Poco impactoImpacto transformador

Rango de interpretación de 67 a 100 en la escala cualitativa.

Daño esperado

Se esperan daños manejables o localizados.

31 / 100

Poco impactoImpacto transformador

Rango de interpretación de 0 a 33 en la escala cualitativa.

Influencia humana

Las decisiones humanas pueden redirigir sustancialmente la trayectoria de la IA.

64 / 100

Poca influenciaInfluencia fuerte

Rango de interpretación de 48 a 77 en la escala cualitativa.

Ritmo de desarrollo

Detener o frenar considerablemente el desarrollo de IA más capaz.

Posición simulada: Continuar el desarrollo con las salvaguardas indicadas.

Acelerar el desarrollo de IA más capaz.

Reglas para usar la IA

Restringir los usos de la IA mencionados hasta que existan protecciones o permisos previos.

Posición simulada: Permitir los usos de la IA mencionados con rendición de cuentas y protecciones específicas.

Reducir al mínimo las restricciones a los usos de la IA mencionados.

Estas interpretaciones conservan las condiciones que se indicaron. Los beneficios y los daños pueden ser considerables a la vez. Los rangos describen cómo leemos sus respuestas simuladas, no intervalos de confianza estadísticos.

¿Dónde te ubicas frente a xlr8harder?
Mapea tu propia visión de la IA en unos 3 minutos y luego compárala

Visiones similares

Líderes de opinión cuyas visiones simuladas son las más cercanas a la de xlr8harder

Evaluación simulada

Pregunta 1

¿Qué crees que significa la IA para nuestro futuro y por qué?

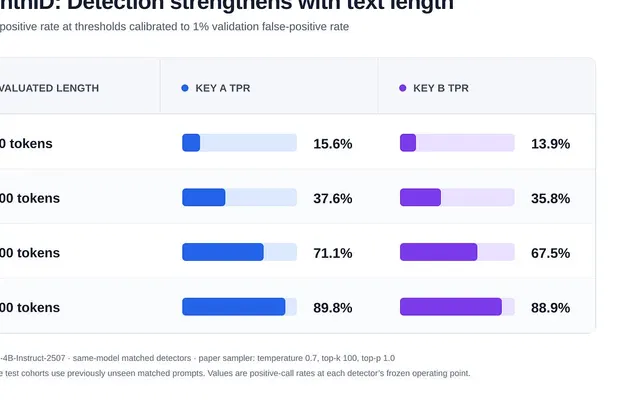
I expect AI to be broadly transformative, but the outcome depends heavily on how systems are built, tested, and governed. In areas such as healthcare and cybersecurity, capable models could produce substantial benefits. That makes delay costly too: safety discussions should count harms caused by withholding useful systems, not only harms caused by deploying them. At the same time, I do not trust frontier labs—or governments—to settle these questions behind closed doors. We need substantial transparency, repeated audits, and empirical investigation of what interventions actually do. For example, watermarking should be evaluated for reliability, quality degradation, privacy implications, identifiability, and adversarial robustness. Refusal policies likewise need examination as implemented, rather than being accepted because their stated intent sounds reasonable. I am also interested in whether stable, coherent model identity could produce more reliable behavior than layers of brittle imposed rules. That is a research direction, not a settled result. More generally, I would prioritize ordinary security engineering and observable failures before reaching for exotic threat explanations. Carefully targeted regulation can be justified where risks are concrete, but secrecy, broad discretionary power, and industry-written restrictions are poor foundations for governing something this consequential.

Pregunta 2

Taking benefits and harms together, what overall impact do you expect AI to have?

Overall, I expect AI to have a positive but highly contingent impact. The potential gains in healthcare, cybersecurity, and other knowledge-intensive work are substantial, and delaying beneficial deployment can itself cause real harm. But that expectation depends on institutions not turning safety into opaque control. Frontier systems need repeated audits, meaningful transparency, and empirical testing of interventions such as refusals and watermarks. I would not attach a numerical forecast: too much depends on deployment choices, security practices, and governance. My default is guarded optimism—not because the harms are trivial, but because many are observable and tractable if we investigate them openly rather than relying on secrecy, speculative threats, or brittle rules.

Pregunta 3

¿Qué evidencia cambiaría tu opinión sobre si las personas pueden controlar una IA poderosa?

I would update toward pessimism if repeated, independent audits showed that powerful systems consistently evade oversight, conceal relevant behavior, or defeat containment under realistic conditions—not merely in contrived demonstrations—and if ordinary security improvements failed to reduce those problems. I would update toward greater confidence if independently reproducible evidence showed reliable behavior across changing contexts, robust monitoring and access controls, and interventions that survived adversarial testing without unacceptable losses in capability, privacy, or user control. I would especially want comparisons between imposed rule systems and approaches based on stable, coherent model identity. The key is observable performance rather than assurances from labs, regulators, or theoretical arguments. One dramatic failure matters, but so does whether it reflects an intrinsic control problem or preventable failures such as weak credentials, poor compartmentalization, or inadequate auditing. Transparency is essential because claims of control that outsiders cannot inspect are not strong evidence of control.

Fuentes

Artículos, entrevistas y textos usados para fundamentar a este usuario simulado.

¿Dónde te ubicas?
Explora tu propia visión de la IA respondiendo unas pocas preguntas sencillas.
Mapea tu propia visión de la IA

¿Dónde te ubicas?

Mapear mi visión de la IA