
Pregunta 1
Robert Miles
x.com/robertskmilesAI safety educator who explains on YouTube why advanced AI may not share human goals and who calls for enforceable limits on frontier AI development.
¿Cómo cambiará la IA el mundo?
Horizontal: su perspectiva Doom–Bloom expresada. Vertical: escala de la transformación.
Doom–Bloom: 6 de 100. Escala de la transformación: 93 de 100. Rangos de interpretación: de 0 a 11 en horizontal y de 88 a 100 en vertical. Son coordenadas de interpretación, no probabilidades de eventos.
10–90%
“any number in the 10 to 90% range is plausibly defensible”
Unspecified AI “doom” as asked on Doom Debates (AI existential catastrophe); he does not define the endpoint
Rob Miles, Top AI Safety Educator: Humanity Isn’t Ready for Superintelligence! · ago 2025
Un supuesto central
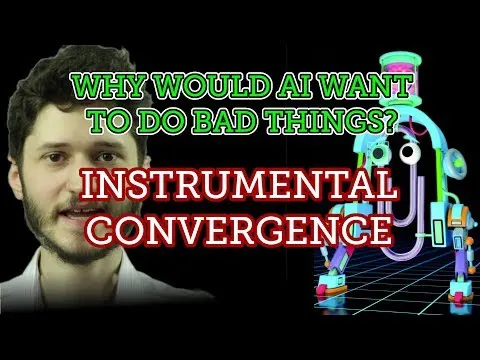
A sufficiently capable agent pursuing the wrong objective may seek resources, improve its own capabilities, and resist shutdown simply because those actions help it achieve almost any long-term goal.Respuesta 1
Si este supuesto resultara distinto, ¿cómo cambiaría su perspectiva?
Una pregunta sin resolver
My uncertainty is extremely broad because the outcome depends less on a fixed property of AI than on what humanity chooses to do—whether we race ahead, pause dangerous development, enforce safety requirements, and make genuine alignment progress.Respuesta 3
¿Qué le ayudaría a distinguir aquí entre los desenlaces plausibles?
Más detalles
Se esperan beneficios sustanciales, con condiciones importantes o límites en su distribución.
61 / 100
Rango de interpretación de 33 a 67 en la escala cualitativa.
Las pérdidas catastróficas o irreversibles ocupan un lugar central en el futuro esperado.
99 / 100
Rango de interpretación de 100 a 100 en la escala cualitativa.
Las decisiones humanas pueden redirigir sustancialmente la trayectoria de la IA.
81 / 100
Rango de interpretación de 50 a 100 en la escala cualitativa.
Se espera que la IA siga siendo un conjunto de herramientas acotadas.
Se espera que la IA iguale a las personas en la mayor parte del trabajo cognitivo.
Posición simulada: Se espera que la IA supere ampliamente a las personas en el trabajo cognitivo.
Posición simulada: Detener o frenar considerablemente el desarrollo de IA más capaz.
Continuar el desarrollo con las salvaguardas indicadas.
Acelerar el desarrollo de IA más capaz.
Estas interpretaciones conservan las condiciones que se indicaron. Los beneficios y los daños pueden ser considerables a la vez. Los rangos describen cómo leemos sus respuestas simuladas, no intervalos de confianza estadísticos.
Visiones similares
Líderes de opinión cuyas visiones simuladas son las más cercanas a la de Robert Miles
Fuentes
Artículos, entrevistas y textos usados para fundamentar a este usuario simulado.
Speaker-attributed interview: Miles calls doom his mainline prediction, while allowing alignment breakthroughs and being fundamentally mistaken in a lucky direction. This is dated pessimism with uncertainty, not an exact probability or a 2050 forecast.

Author’s introductory safety talk; accessible primary video metadata establishes topic and authorship, not a fresh quantitative forecast.

Miles’s own answers at 21:58–30:50 allow a broad 10–90% risk range, with uncertainty dominated by societal response. At 1:45:46–1:48 he supports pausing AGI/superintelligence development, particularly AI-research agents, while welcoming useful narrow AI. The host’s numerical framing is not his estimate.

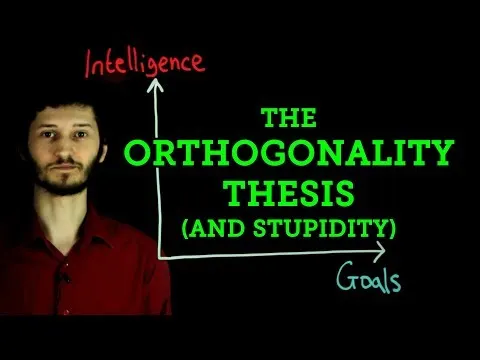
Explains why effectiveness at pursuing goals does not entail human-compatible goals: understanding morality is different from wanting to act morally. Foundational argument about possible agents, not a measured claim about every current model.

Given sufficiently capable goal-directed agents, many goals incentivize resources, self-improvement and resistance to shutdown or goal changes. These are instrumental pressures, not human malice; the argument preserves exceptions and depends on agentic competence.

Advocates deployment obligations and control protocols as interim safeguards, not an alignment solution or assurance for superintelligence. Benchmark attack success is not real-world extinction probability.

Evaluación simulada
Pregunta 2
¿Cuánto crees que la IA acabará cambiando el mundo?
Pregunta 3
¿Cuál es tu estimación intuitiva de la probabilidad de que la IA cause la extinción humana o una catástrofe permanente similar?
Pregunta 4
¿Qué presiones crees que determinarán cómo abordan la seguridad las empresas de IA?
¿Dónde te ubicas?
Mapear mi visión de la IA